Hugging Face
Models
Datasets
Spaces
Buckets
new
Docs
Enterprise
Pricing
Website
Tasks
HuggingChat
Collections
Languages
Organizations
Community
Blog
Posts
Daily Papers
Hardware
Learn
Discord
Forum
GitHub
Solutions
Team & Enterprise
Hugging Face PRO
Enterprise Support
Inference Providers
Inference Endpoints
Storage Buckets
Log In
Sign Up
fulong ye
Alon77777
15
35
5
Follow
jiangjin's profile picture
Nadilazev's profile picture
sigridjineth's profile picture
10 followers
·
1 following
https://scholar.google.com.hk/citations?hl=zh-CN&user=-BbQ5VgAAAAJ
superhero-7
AI & ML interests
vision and language, diffusion model, text-to-image generation, image-to-text generation, referring expression generation and comprehension
Recent Activity
liked
a model
about 20 hours ago
LightOriginsHQ/Light-O1-Preview
upvoted
a
paper
21 days ago
LightNav-0: Eliciting VLM Spatial Intelligence for Generalist Embodied Navigation
authored
a paper
5 months ago
SPRING: Situated Conversation Agent Pretrained with Multimodal Questions from Incremental Layout Graph
View all activity
Organizations
Alon77777
's papers
10
arxiv:
2604.14148
arxiv:
2602.12160
arxiv:
2601.14250
arxiv:
2601.01425
arxiv:
2510.08485
arxiv:
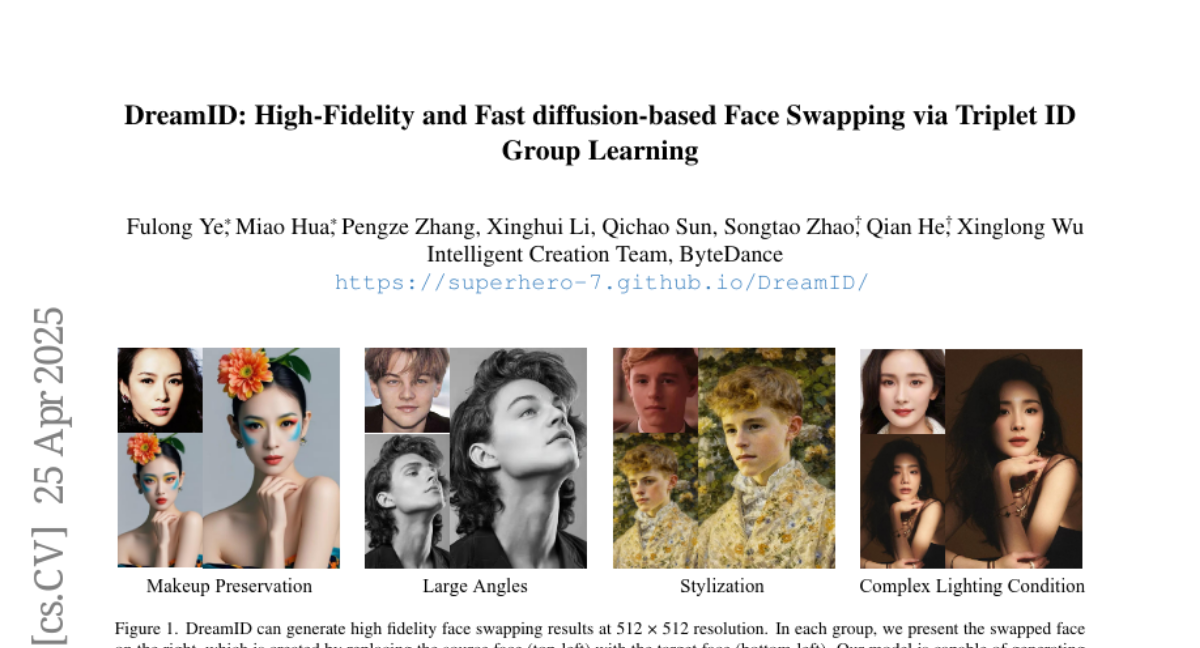
2504.14509
arxiv:
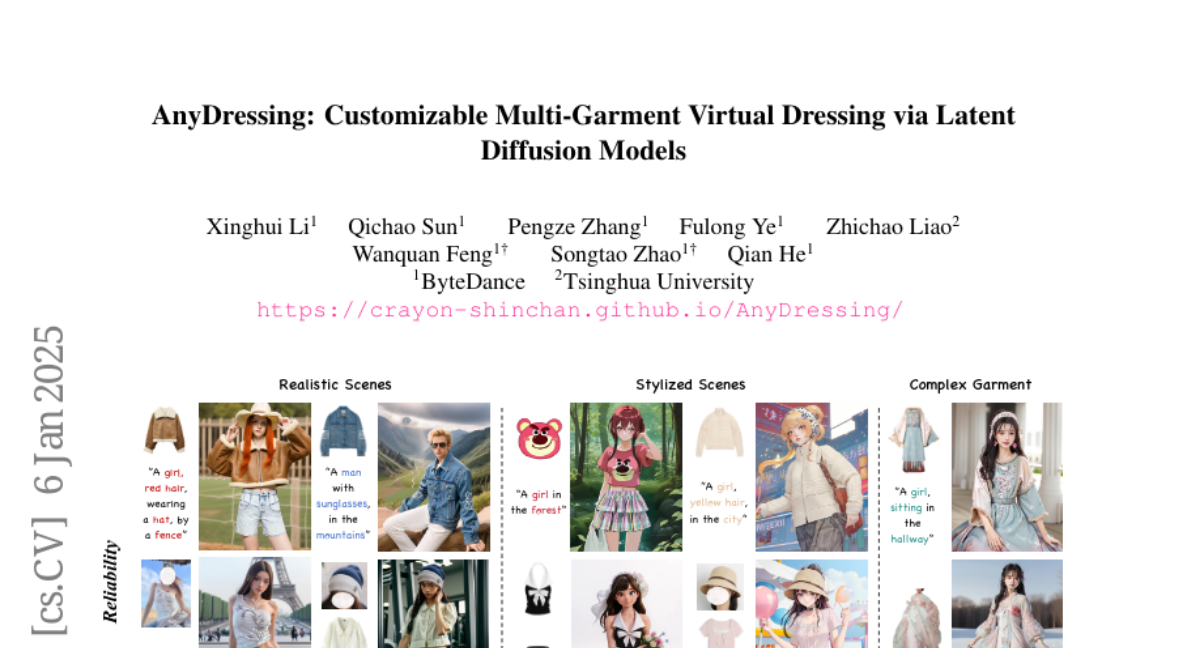
2412.04146
arxiv:
2308.09991
arxiv:
2301.01949
arxiv:
2211.06679